Código MRZ del pasaporte: campos, lectura y validación
Cómo se organizan las dos líneas MRZ de un pasaporte, cómo se calculan sus dígitos de control y por qué una MRZ correcta no prueba autenticidad.

Una MRZ puede pasar todos sus dígitos de control y estar en un documento falso. El cálculo detecta buena parte de los errores de lectura y de las ediciones accidentales, pero un falsificador que conozca el algoritmo también puede recalcularlo. Si su sistema lee check digit = valid como passport = authentic, saca de una cuenta aritmética una conclusión forense que esa cuenta no sostiene.
Aun así, la zona de lectura mecánica (Machine Readable Zone o MRZ) del pasaporte hace un trabajo concreto en la verificación documental eKYC. Pone los datos visibles en una estructura fija que se puede leer, comparar y usar para acceder al chip. Para sacarle partido sin atribuirle más de lo que da, separe cuatro resultados: lectura, sintaxis, coherencia con otras zonas y autenticidad del documento.
En breve
En un pasaporte TD3, la MRZ tiene dos líneas de 44 caracteres.
La primera línea identifica tipo, Estado emisor y nombre; la segunda contiene número, nacionalidad, fechas, sexo y datos opcionales.
Los dígitos se calculan con valores definidos, pesos repetidos 7–3–1 y módulo 10.
Un dígito correcto indica que el campo leído es coherente en lo matemático. Sobre la emisión legítima no dice nada.
El control que aporta algo compara la MRZ, la zona visual y, si los hay, los datos firmados del chip.
Anatomía de las dos líneas TD3
La parte 4 del Doc 9303 de la OACI especifica la MRZ para pasaportes y otros documentos TD3. Solo admite el alfabeto latino en mayúsculas, dígitos y el carácter de relleno <. Los espacios, los signos diacríticos y los demás caracteres no admitidos se transliteran o se representan según las reglas del estándar.
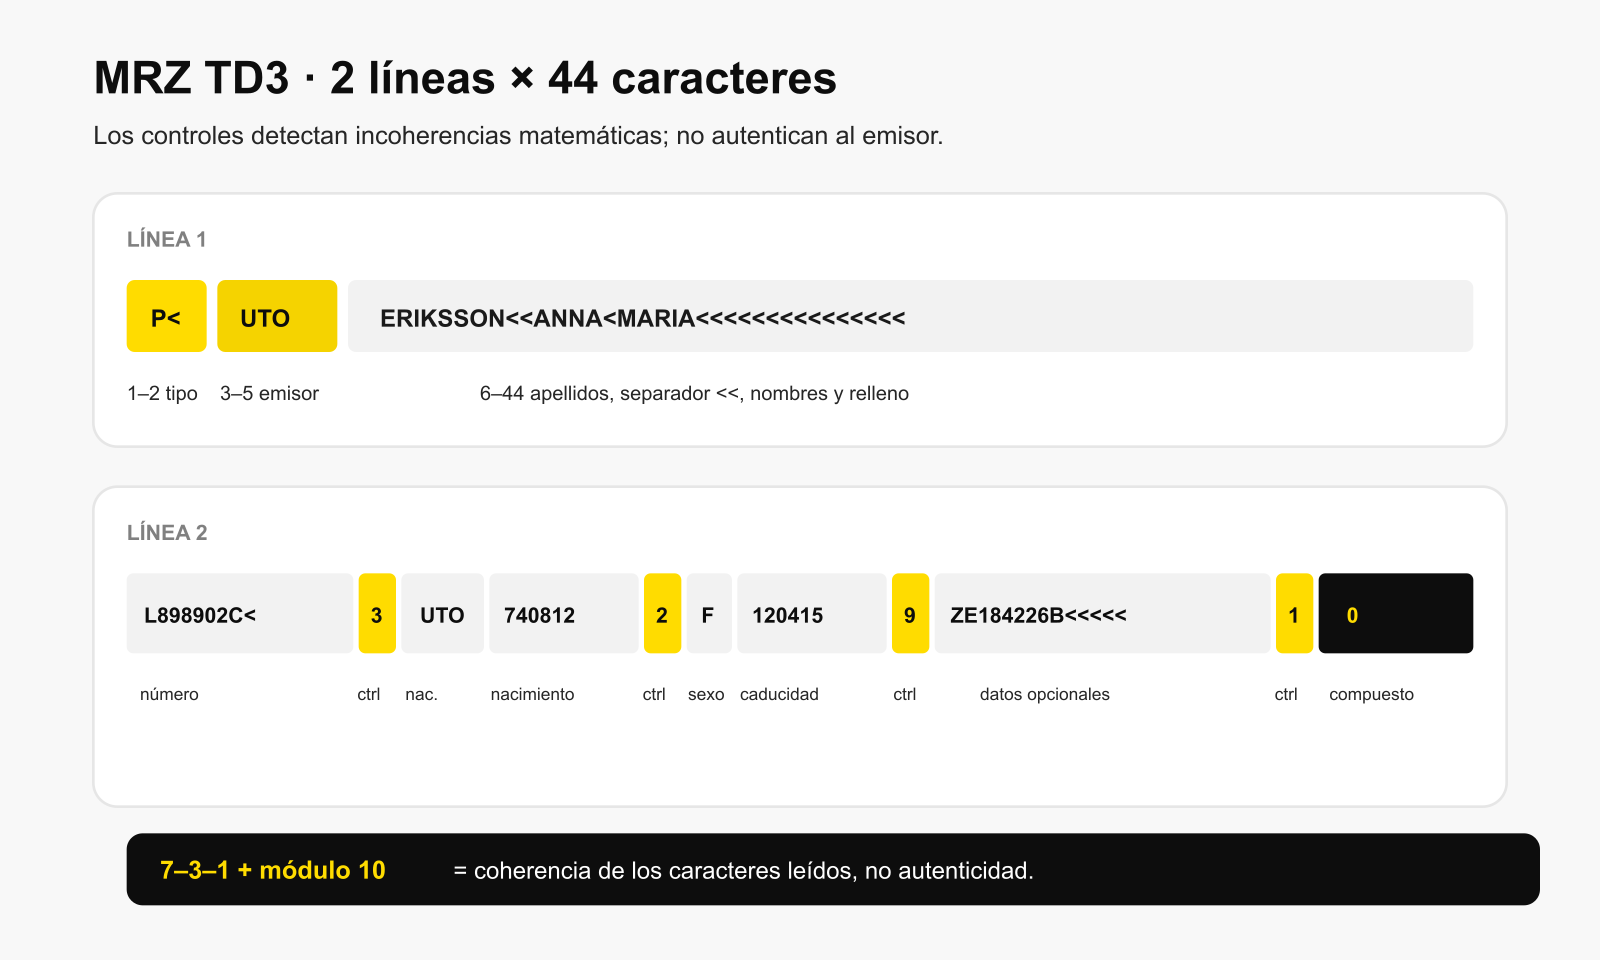
Primera línea: documento, emisor y nombre
Según la estructura TD3 de la OACI, las posiciones 1–2 contienen el código del documento. En un pasaporte, la primera suele ser P; la segunda puede precisar el tipo o quedar como relleno. Las posiciones 3–5 identifican al Estado u organización emisora con un código de tres letras. Las 39 posiciones restantes contienen el nombre.
El separador << divide el identificador primario, que suele ser los apellidos, de los nombres. Un solo < sustituye espacios o rellena posiciones vacías. Si la cadena tiene menos palabras que la zona visual, no hay que darlo por error: el campo tiene una longitud fija y reglas de truncamiento. Guarde la cadena original y el valor normalizado. Si el motor borra los separadores, luego cuesta reproducir la lectura.
Segunda línea: campos que deciden la validación
La especificación oficial distribuye los 44 caracteres de la línea inferior así:
Posiciones | Contenido | Control inmediato |
|---|---|---|
1–9 | Número de pasaporte | Posición 10 |
11–13 | Nacionalidad | No |
14–19 | Fecha de nacimiento | Posición 20 |
21 | Sexo: | No |
22–27 | Fecha de caducidad | Posición 28 |
29–42 | Datos opcionales o personales | Posición 43 |
44 | Dígito compuesto | Sí, sobre varios segmentos |
Con dos cifras de año, la fecha no dice a qué siglo pertenece. El sistema lo deduce del tipo de documento, las fechas visibles y reglas de plausibilidad. Si esa deducción no queda registrada, un OCR correcto puede acabar en una fecha equivocada sin que nadie lo note. Registre por separado el valor MRZ bruto y la fecha interpretada.
Cómo se calcula un dígito de control
La parte 3 del Doc 9303 asigna a los dígitos su valor numérico, a las letras valores de A=10 a Z=35 y a < el valor cero. Después aplica los pesos 7, 3, 1 de izquierda a derecha y los repite hasta terminar el campo. La suma de productos se divide por 10; el resto es el dígito de control.
Ejemplo reproducido a partir del método de la parte 3 del Doc 9303: para L898902C<, los valores son 21, 8, 9, 8, 9, 0, 2, 12, 0; al aplicar 7, 3, 1 de forma repetida, los productos suman 313, y 313 mod 10 da 3.
El carácter esperado después del número es 3, conforme al algoritmo de la OACI. Si el OCR confundiera C con G, el control cambiaría y marcaría la lectura como inconsistente. Pero quien cambie el número a propósito y recalcule el carácter final tendrá otra cadena igual de válida para el algoritmo.
El dígito compuesto detecta combinaciones, no falsificaciones
La última posición de la segunda línea se calcula sobre el número de documento y su control, la fecha de nacimiento y su control, la fecha de caducidad y su control, además de los datos opcionales y su control. Así los campos quedan enlazados, y quien edite uno tiene que actualizar también el compuesto.
Con todo, sigue siendo una prueba de consistencia. El algoritmo es público a propósito y no usa ninguna clave secreta del Estado emisor. La prueba criptográfica está en otra capa: el chip electrónico guarda un objeto firmado cuyos hashes cubren grupos de datos. Validar esa firma contra una cadena de confianza da una evidencia de otra clase que un módulo 10 correcto, como detalla la parte 11 del Doc 9303.
Errores de OCR que exigen una segunda lectura
La tipografía OCR-B reduce ambigüedades. Una fotografía, en cambio, trae reflejos, perspectiva, desenfoque y compresión. Los errores más caros aparecen cuando el sistema corrige un carácter y descarta la duda que tenía sobre él.
Un flujo bien hecho trata cada campo así:
detecta la zona y rectifica la perspectiva conforme al formato del Doc 9303;
conserva imagen recortada y cadena bruta;
calcula controles sin autocorregir primero;
genera candidatos solo para caracteres dudosos;
contrasta el candidato con la zona visible y el chip;
escala si varias cadenas pasan o las fuentes discrepan.
Los pares O/0, I/1, B/8 y ciertas letras dañadas son confusiones visuales típicas, aunque no todas pueden darse en cualquier posición. Saber qué campo se lee recorta los candidatos: una fecha solo acepta dígitos y el código de nacionalidad usa letras. Esa restricción ayuda a leer mejor, pero no permite rellenar un dato que falta.
Matriz de decisión: qué hacer con cada resultado
MRZ | Zona visual | Chip firmado | Acción razonable |
|---|---|---|---|
Controles fallan | Coincide parcialmente | No leído | Repetir captura; no declarar fraude todavía |
Controles pasan | Datos discrepan | No leído | Bloquear automatización y revisar manipulación o lectura |
Controles pasan | Coincide | Firma no validada | Tratar como verificación visual, no electrónica |
Controles pasan | Coincide | Firma e integridad válidas | Continuar con vínculo al titular y reglas de riesgo |
La matriz es una recomendación de diseño y no una categoría de la OACI. Sirve para que el sistema no convierta un indicador de calidad en una decisión definitiva.
Qué debe quedar en el expediente
Para reproducir el resultado, registre la imagen utilizada, las dos líneas brutas, el motor y su versión, confianza por carácter, dígitos esperados y observados, correcciones, coincidencias con la zona visual y estado del chip. Quien revise el caso tiene que ver la discrepancia concreta; un aviso genérico no le basta para decidir.
Document Verification de Biometric.Vision puede extraer la MRZ y analizar señales declaradas del documento. De los documentos admitidos, las fuentes externas, la tolerancia a errores y la decisión final sigue respondiendo la empresa. Si el proceso tiene que autenticar un pasaporte electrónico, añada lectura NFC y validación criptográfica. La MRZ alimenta ese control y no lo reemplaza.
Fuentes
¿Quieres reforzar las verificaciones de tus clientes?
500 verificaciones gratis al mes sin tarjeta, sin contrato, sin llamada comercial.